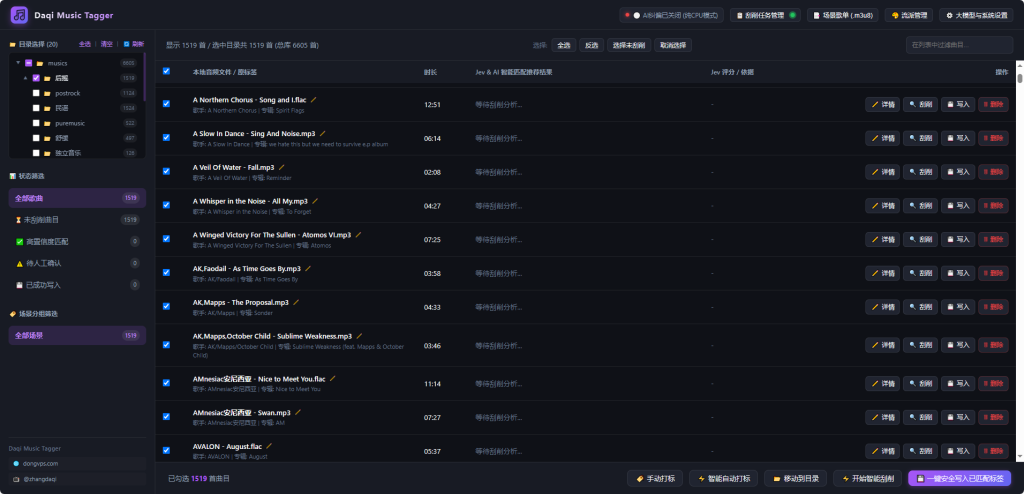
工具档案卡
* 软件名称:Daqi Music Tagger (大旗音乐刮削系统)
* 最新版本:v2.0 (Latest)
* 官方镜像:halucinar/daqi-music-tagger:latest(原生支持linux/amd64与linux/arm64双架构)
* 授权方式:完全免费软件(虽非开源,但向所有家庭 NAS、私有云及个人音乐爱好者永久免费开放)
* 技术底座:Go 1.22+ 原生高并发后端 + 现代化暗黑响应式 Web UI + 双模持久化 Redis 存储引擎
* 完美适配生态:Navidrome / Jellyfin / Emby / Plex / Subsonic / Symfonium
1. 项目概述与设计理念
在私有音乐服务(如 Navidrome、Jellyfin、Emby、Plex、Subsonic、Symfonium)的日常使用中,广大音乐爱好者与 NAS 玩家常面临三大长期无法根治的顽疾:
- 网络刮削工具笨重脆弱:许多传统工具依赖庞大繁琐的 Python 环境或重量级依赖链,批量刮削时动辄卡死、内存泄露或连接阻塞,面对成千上万首曲目的大型曲库往往力不从心;
- 大模型滥用导致效率低下:部分新兴工具盲目将每一首歌曲都送入大语言模型(LLM)进行理解推断,不仅单核处理耗时极长、API Token 额度消耗惊人,而且大模型在精准匹配专有名词时存在严重的“幻觉”现象;
- 标签覆盖损坏已有元数据:给音乐打标签时常常简单粗暴地全量覆写,破坏了用户已经精心校对好的封面插图、内嵌歌词或音轨编号。
Daqi Music Tagger 正是为彻底解决上述行业痛点而量身定制研发的轻量化生产力工具:
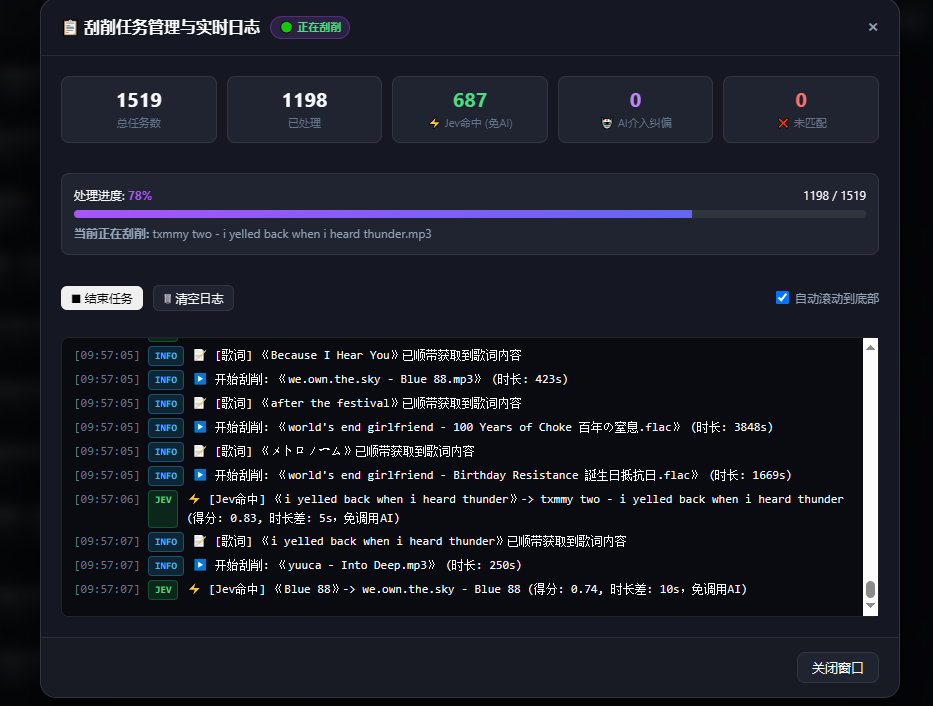
- 纯粹自研与极速吞吐:剥离大模型对常规刮削链路的依赖,直连主流音源平台公开接口,毫秒级精准获取高清专辑封面、动态滚动歌词与标准化元数据;
- 流派与刮削彻底解耦:刮削归刮削,打标归打标。用户可按需主动进入“流派治理中心”,以“艺术家(Artist)”为核心聚合维度统一治理曲风,杜绝全库风格碎片割裂;
- 绝对的数据物理安全:物理写入采用独立的 ID3v2 Grouping 帧隔离机制与
.daqi_tmp原子替换,绝不破坏现有的高质量封面与其它关键音频元数据; - 双架构支持,开箱即用:官方 Docker 镜像原生支持 ARM64(Apple Silicon / 树莓派 / ARM NAS / RK3588)与 x86_64 双平台,开箱即用,单容器启动即可获得完整的企业级音乐治理体验。
2. 核心技术架构
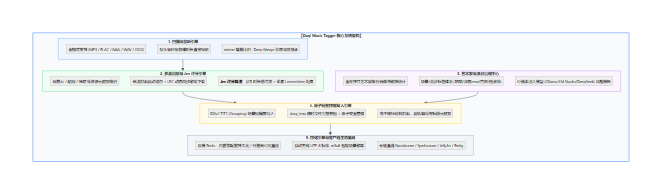
- ARM64 与 x86_64 原生多架构构建:官方镜像提供原生的
linux/amd64与linux/arm64跨平台支持。无论是在 Intel/AMD x86_64 传统 NAS、云服务器,还是在搭载 Apple Silicon (M1/M2/M3/M4) 的 Mac 迷你主机、树莓派 5、RK3588 软路由及采用 ARM 芯片的群晖/威联通机型上,均可直接原生拉取运行,无需任何 QEMU 模拟,性能损耗为零; - 语言栈优势:采用 Go 1.22+ 原生静态编译,生成的单一二进制可执行文件体积仅约 9.7MB,运行时内存占用仅数十兆,零任何 CGO 动态链接库依赖;
- 双模存储后端:支持内置持久化 Redis 引擎(用户无需提前准备或额外配置任何数据库容器,挂载即用),并支持一键无缝切换至宿主机已有的外置高可用 Redis 服务;
- 超高并发调度:借助 Go 协程(Goroutine)原生高并发优势,扫描解析 1,000+ 首无损曲目通常在 2~3 秒 内瞬时完成,网络批量刮削流水线内置动态限流防封机制,兼顾速度与平稳性。
3. 功能模块全景详解
3.1 音乐库增量扫描引擎
- 全格式无缝支持:深度解析
.mp3、.flac、.m4a、.wav、.ogg、.ape等常见有损与无损音频封装。 - 底层精准物理时长探测:扫描过程中直接快速解析底层音频流的帧头数据,提取毫秒级物理播放时长(这是高质量刮削防翻车、杜绝翻唱同名歌的最关键物理指纹)。
- 增量深度合并保护(Deep Merge):重新扫描时,系统智能比对文件修改时间(
mtime)。对仅发生标签变动的文件,自动继承并保留原先已获取的候选元数据、歌词与刮削状态,绝不重复刮削或重置数据。
3.2 极速多平台刮削流水线
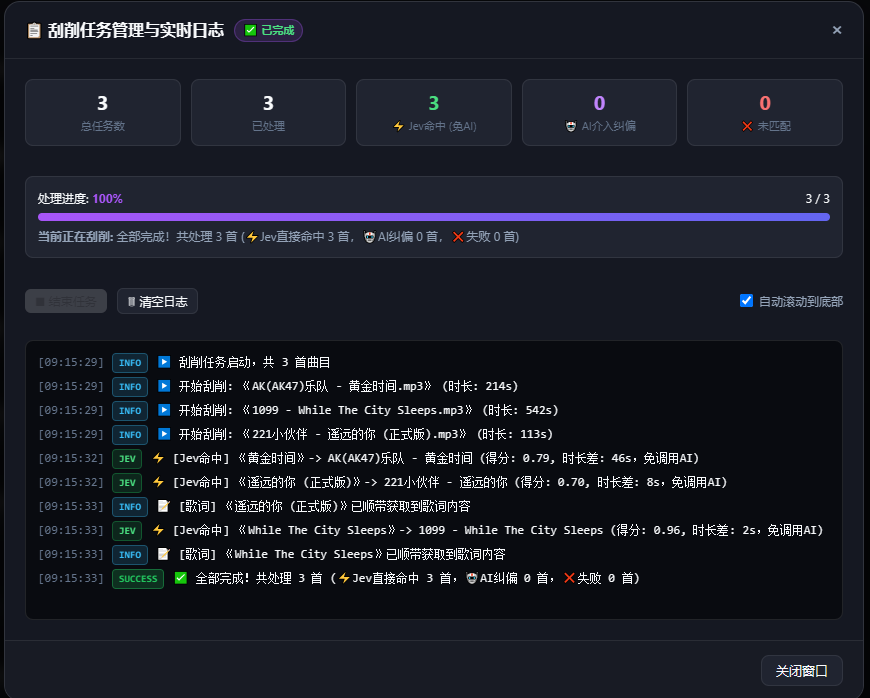
- 直连国内主流音乐服务平台公开元数据通道,获取内容包含:
- 标准化曲名、标准化艺术家列表、正版专辑全称、发行年份
- 超高清正版专辑封面(自动下载高速缓存,并支持一键物理嵌入)
- 同步滚动歌词(LRC)与纯文本完整歌词
- 刮削流水线作业完全独立于大模型,纯网络 I/O + 本地内存哈希比对,单曲平均处理延迟仅在 50~150 毫秒 之间。
3.3 Jev 综合置信度评分算法
为彻底防止“同名不同曲”、“Live现场翻唱混淆”或“冷门错版歌曲”导致的误刮削,Daqi 独创研发了 Jev 综合置信度算法:
- 音频时长硬约束判定:
– 算法精准计算目标本地音频与候选音源之间的物理时长差值 $|\Delta T|$;
– 若时长差异超过 10 秒,该候选的置信度将遭到指数级数学惩罚;
– 若时长差异精准落在 0~2 秒内,赋予满额物理时长权重。 - 核心曲名清洗与归一化:
– 自动正则过滤消除(Live)、[Remix]、【正式版】、各类影视原声插曲标注等非核心修饰语,提取纯文本标题主干。 - 词素 Levenshtein 距离:
– 对比清洗后的歌手名与歌曲名,加权合成综合得分(0.00 ~ 1.00)。
– 得分 $\ge 0.70$:标记为高置信度命中,支持全自动批量采纳;
– 得分 $< 0.70$:标记为次优候选,前端给予清晰警示并支持人工核验。
3.4 单曲候选精准点选与重搜
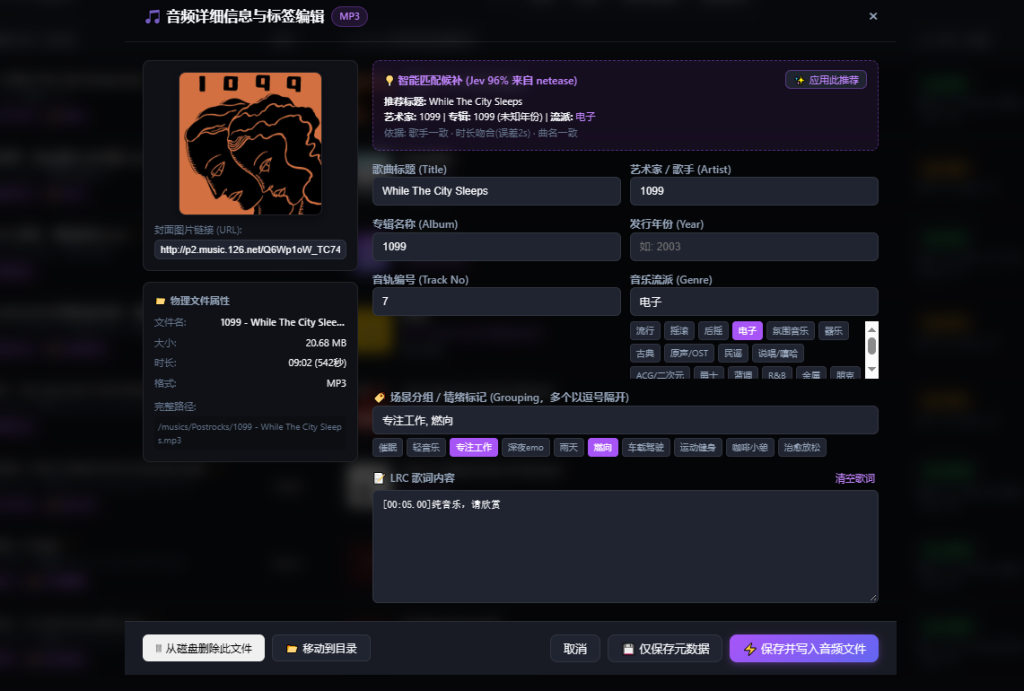
- 在曲目列表中,用户对任何歌曲均可点击右侧的【🔍 刮削】或【编辑】;
- 弹窗中即时呈现各音源平台的搜索候选,横向直观展示:音源标识、歌曲标题、歌手、专辑、物理时长、封面预览与 Jev 匹配得分;
- 支持在弹窗内自定义输入“曲名 / 歌手”手动重试搜索,自由挑选最满意的版本一键【采纳并写入】。
3.5 独立艺术家与流派治理中心
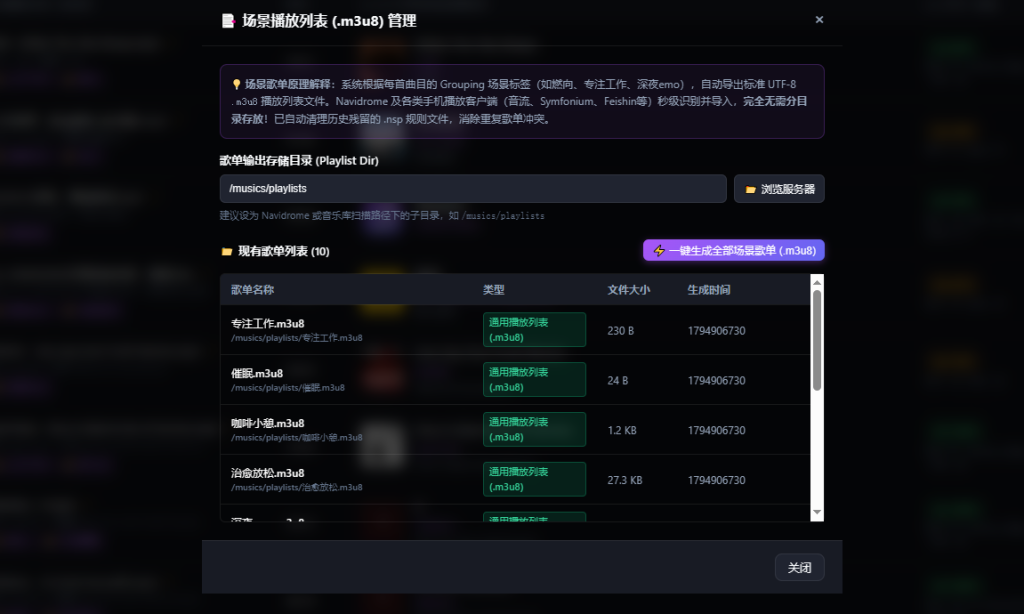
将“流派打标”与“元数据刮削”在产品形态上彻底解耦,极大降低了用户治理整个曲库的心智负担:
- 全库聚合:系统自动汇总音乐库中出现的所有独立艺术家,统计其名下歌曲数量;
- 场景/流派标签体系:内置“燃向”、“深夜emo”、“运动健身”、“民谣/治愈”、“摇滚/朋克”、“说唱/HIPHOP”、“电子/EDM”、“古典/纯音乐”等高频分类标签;
- 本地大模型风格推断(可选):
– 支持自由配置 LM Studio、Ollama、DeepSeek、OpenAI 等标准兼容接口;
– 针对未知风格或冷门艺术家,支持按需一键分析,AI 自动根据其代表作与艺术流派返回建议标签,并入库保存为永久音乐人画像; - 一键批量打标:
– 艺术家画像确定后,点击【批量打标到歌曲】,系统自动将流派应用至该歌手名下的所有单曲。
3.6 标签隔离写入与原子保全机制
- Grouping 帧隔离:流派标签专门写入 ID3v2
TIT1(Grouping 内容分组)帧,完全独立于标题(TIT2)、艺术家(TPE1)、专辑(TALB)与封面(APIC); - 原子替换(Atomic Swap):先向目标目录写入同名的
.daqi_tmp临时文件,校验文件完整且无损后再执行系统级原子替换。若发生断电或写中断,原始音乐文件不受任何损坏。
3.7 Navidrome / Symfonium 智能场景歌单
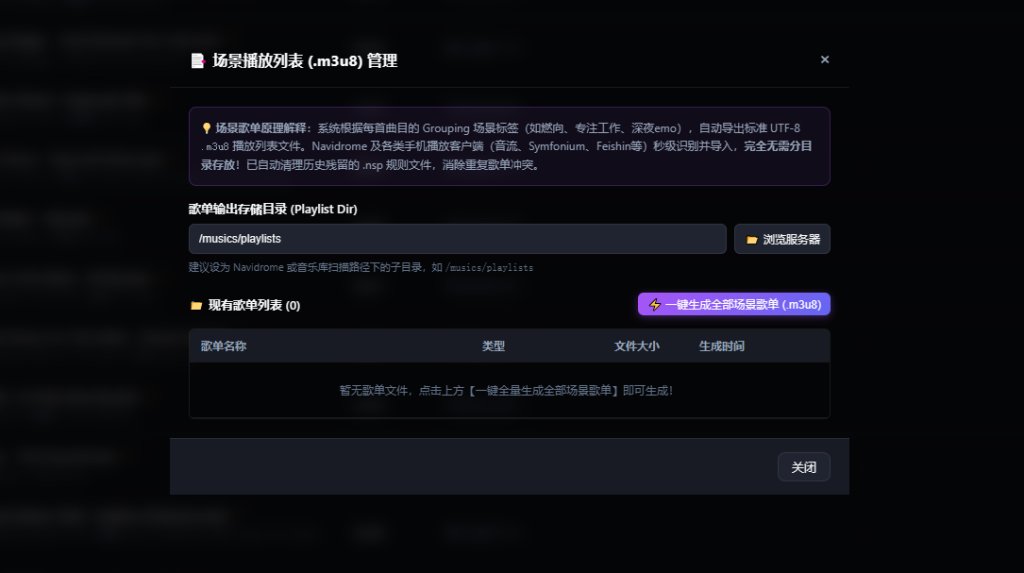
- 根据流派标签,系统自动在播放列表目录生成通用 UTF-8 编码的
.m3u8歌单文件(如燃向.m3u8、深夜emo.m3u8); - Navidrome、Jellyfin 等服务端开箱即认,客户端中无需手动创建歌单即可享受智能分类播放。
4. 部署与安装教程
Portdeck可一键部署,Portdeck
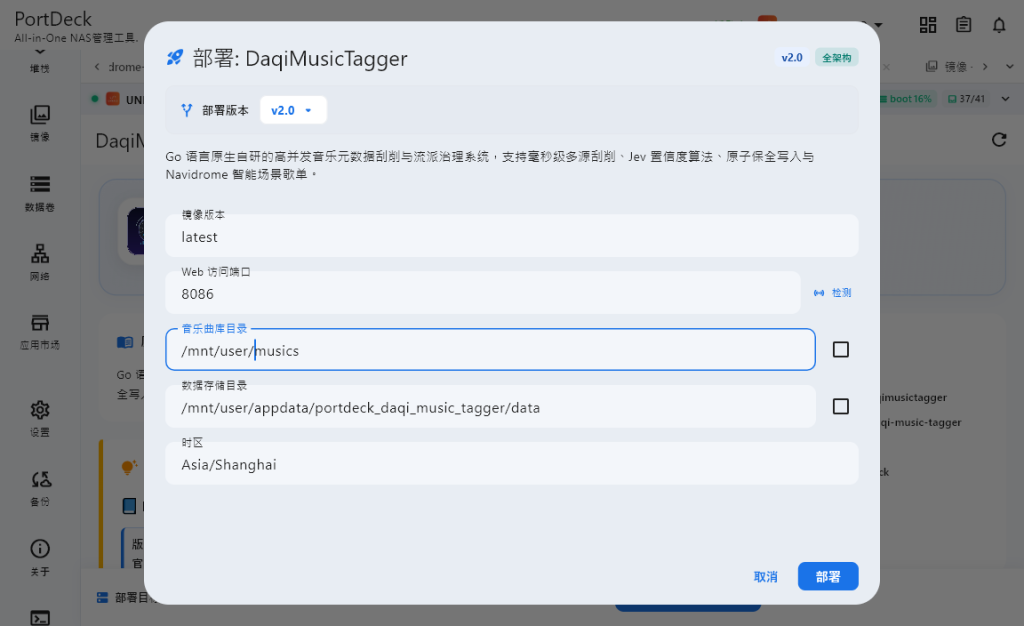
4.1 方式一:Docker CLI 单命令直接运行(推荐 · 内置 Redis)
docker run -d \
  --name daqi-music-tagger \
  --restart unless-stopped \
  -p 8086:8080 \
  -v /mnt/user/music:/musics \
  -v /mnt/user/appdata/daqi-tagger/data:/data \
  -e TZ=Asia/Shanghai \
  halucinar/daqi-music-tagger:latest
部署要点提示:
* 架构自适应:镜像原生包含linux/amd64与linux/arm64Manifest 清单,Docker 守护进程会自动识别并拉取对应架构的镜像版本,无论是 x86 宿主机还是 ARM 架构 NAS 均能完美无损跑满性能;
* 官方镜像已内置零配置持久化 Redis 引擎,数据自动保存在宿主机的/mnt/user/appdata/daqi-tagger/data/redis目录下;
* 启动成功后,直接在浏览器中打开http://宿主机IP:8086/即可进入管理面板。
4.2 方式二:Docker Compose 编排部署
创建 docker-compose.yml 配置文件:
version: '3.8'

services:
  daqi-tagger:
    image: halucinar/daqi-music-tagger:latest
    container_name: daqi-music-tagger
    restart: unless-stopped
    ports:
      - "8086:8080"
    volumes:
      - /mnt/user/music:/musics
      - /mnt/user/appdata/daqi-tagger/data:/data
    environment:
      - TZ=Asia/Shanghai
      - MUSIC_DIR=/musics
      - DATA_DIR=/data
      - PORT=8080
      # 若要连接宿主机上已有的外部 Redis,取消下一行注释:
      # - REDIS_ADDR=192.168.100.77:6379
一键启动容器集群:
docker compose up -d
4.3 Unraid / 群晖 Synology / 威联通 QNAP 部署建议
Unraid NAS 系统:
- 打开 Docker 界面,点击底部的【添加容器】;
- 名称:
daqi-music-tagger; - Repository:
halucinar/daqi-music-tagger:latest; - 端口映射:容器端口
8080,宿主机端口指定为8086; - 路径映射 1:容器路径
/musics映射至你的 Unraid 音乐共享目录(如/mnt/user/music,给予读写权限); - 路径映射 2:容器路径
/data映射至 appdata 持久化目录(如/mnt/user/appdata/daqi-tagger/data)。
群晖 Synology (Container Manager):
- 打开 Container Manager,在【注册表】搜索并下载
halucinar/daqi-music-tagger:latest; - 启动向导中,端口映射将本地端口设为
8086,容器端口设为8080; - 卷设置中,将存放音乐的群晖共享文件夹挂载为
/musics,将 docker 专用配置文件夹挂载为/data; - 应用设置并启动容器(ARM 架构群晖会自动拉取 arm64 版本,x86 群晖自动拉取 amd64 版本)。
5. 新手上手:标准操作四步法
步骤一:初始全库扫描
- 容器启动并挂载音乐目录后,打开 Web 界面
http://<IP>:8086; - 系统会自动拉取音乐列表,右上角实时显示当前曲库曲目总数、已刮削数与待刮削数;
- 若后续有新音乐拷贝入库,随时点击顶部的【🔄 重新扫描】按钮即可。
步骤二:执行元数据刮削
- 方式 A(批量极速刮削):
1. 勾选需要刮削的曲目(支持筛选“未刮削”状态歌曲);
2. 点击顶部【🚀 批量刮削】按钮;
3. 系统开启并发刮削,Jev 引擎秒级自动匹配最佳音源,并下载封面与歌词;
4. 确认候选无误后,点击【💾 批量写入标签】将元数据物理固化至音频文件中。 - 方式 B(单曲精准核对):
1. 点击任意单曲操作栏右侧的【🔍 刮削】按钮;
2. 弹窗中即时展示所有候选音源及匹配度评分;
3. 选中最精准的候选,点击【采纳并写入】即可单曲瞬时完成。
步骤三:流派治理与场景打标(可选)
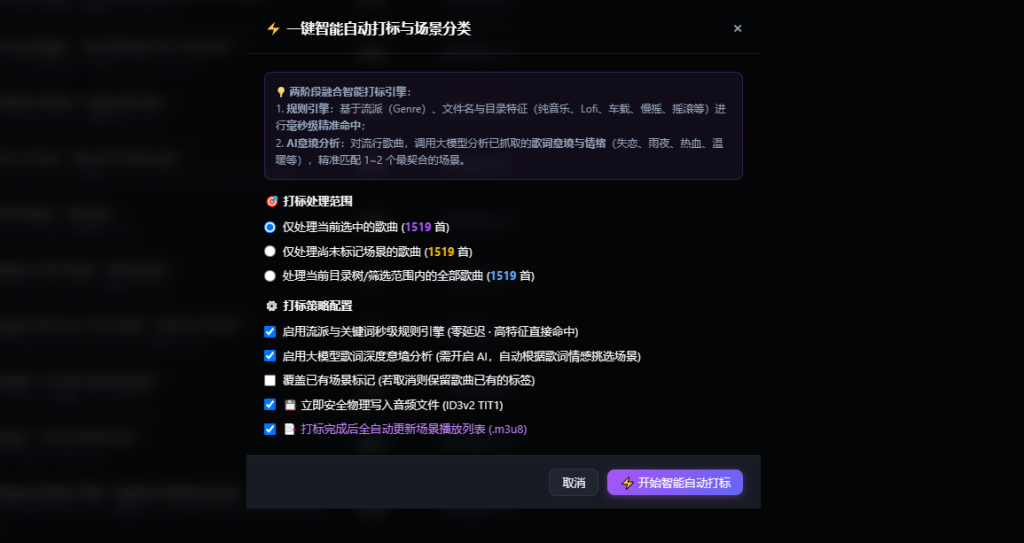
- 点击顶部导航【🎨 流派管理】打开艺术家治理面板;
- 面板左侧按歌手聚合,呈现各歌手名下曲目数;
- 可直接为歌手勾选流派标签(如“摇滚/朋克”、“深夜emo”等);
- 若不确定风格,可点击【🤖 AI 智能推断】,大模型将结合艺术家代表作给出推荐流派;
- 点击【批量打标到歌曲】,流派信息将通过独立 Grouping 帧写入歌曲文件。
步骤四:与媒体播放器同步
- 生成的场景歌单存放于播放列表目录中(默认为音乐库内的
playlists目录); - 在 Navidrome 或 Symfonium 中执行一次曲库扫描,即可在“流派(Genre)/分组(Grouping)”中查看打标结果,并在“播放列表(Playlists)”中即点即播各场景歌单。
6. 配置项与环境变量全表
| 变量名 / 配置项 | 默认值 | 说明 |
|---|---|---|
PORT | 8080 | 容器内部 HTTP 监听端口 |
MUSIC_DIR | /musics | 音乐库根目录容器内挂载路径 |
DATA_DIR | /data | 持久化数据与缓存目录(内置 Redis 存储路径) |
REDIS_ADDR | 127.0.0.1:6379 | Redis 服务连接地址。留空或填本地将自动启动容器内置 Redis |
AI_BASE_URL | http://localhost:1234/v1 | OpenAI 兼容接口地址(支持 LM Studio / Ollama / DeepSeek 等) |
AI_API_KEY | lm-studio | 大模型接口访问凭证(本地模型通常随意填写) |
AI_MODEL | 自动识别 | 选用的大模型名称 |
TZ | Asia/Shanghai | 容器时区设置 |
7. 常见问题解答 (FAQ)
Q1: 为什么批量打标后,刮削状态没有被重置?
答:Daqi Music Tagger v2.0 引入了标签隔离写入与增量深度保护机制。打标时仅改写音频文件的 ID3v2 Grouping 帧,不破坏其它字段;重新扫描时系统会自动继承此前已获取的封面、歌词与刮削状态。
Q2: 刮削时报错“文件无法写入”或“Permission Denied”?
答:请检查挂载的音乐文件夹权限。确保宿主机运行 Docker 的用户对该文件夹拥有写权限(在 Unraid 或 Linux 下可通过
chmod -R 777 /path/to/music或确保 PUID/PGID 正确分配写入权限)。
Q3: 本地没有部署大模型,还可以使用这个系统吗?
答:完全可以,且毫不影响!核心刮削流水线(搜歌、下封面、匹配歌词、Jev置信度分析)全部采用原生算法直连音源平台,不需要任何大模型。大模型仅在您进入“流派管理”面板并主动要求推断未知冷门艺术家的风格时才会按需调用。
Q4: 歌单文件生成在什么位置?Navidrome 如何识别?
答:歌单以标准的 UTF-8
.m3u8格式生成在音乐库根目录的playlists/文件夹内。只需在 Navidrome 配置中确保能够扫描到该目录,Navidrome 会自动将它们载入为原生播放列表。
Q5: 软件虽非开源,使用会收费吗?有无隐藏限制?
答:永久免费,无任何歌曲数量限制或隐藏收费。我们致力于为所有搭建自托管影音库的朋友提供一把趁手利刃,官方 Docker 镜像将持续保持免费更新与维护。
版权声明:本文由 大七先生 原创发布于 DongVPS。
采用 CC BY-NC-SA 4.0 许可协议,商业转载请联系作者,非商业转载请注明原文链接。